Stratégies de limitation de débit d'API pour développeurs
Comparez fenêtre fixe, fenêtre glissante, seau à jetons et seau percé, codez-les atomiquement avec Redis Lua et renvoyez les en-têtes RateLimit.
Relu par Maurice Sobiera
La limitation de débit d’API plafonne le nombre de requêtes qu’un client peut envoyer sur une période, pour qu’un client ne surcharge pas le service ni ne prive les autres. Pour la plupart des API publiques, un compteur à fenêtre glissante est un bon choix par défaut : il est presque exact et utilise une mémoire constante. Utilisez un seau à jetons pour autoriser des rafales.
TL;DR :
- Un compteur à fenêtre glissante équilibre précision et mémoire, ce qui convient aux API publiques générales à fort trafic.
- Les scripts Redis Lua rendent atomiques les étapes de lecture, de recharge et de consommation, afin que les requêtes concurrentes ne se disputent pas.
- Un taux de recharge légèrement supérieur au trafic p99 habituel et une capacité de 5 à 10 secondes de rafale sont des valeurs de départ raisonnables.
- Indiquez aux clients leurs limites avec les en-têtes RateLimit, et envoyez Retry-After avec chaque réponse 429.
- Appliquez les limites à la périphérie et dans l’application, et décidez pour chaque point de terminaison ce qui se passe lorsque Redis est indisponible.
Table des matières
- Comment les principaux algorithmes de limitation de débit se comparent-ils ?
- Notes d’implémentation pour chaque algorithme
- Comment construire un limiteur qui fonctionne entre instances ?
- Quel algorithme convient à quel point de terminaison ?
- Comment indiquer aux clients leurs limites ?
- Régler les taux de recharge, la capacité et les alertes
- Où ces motifs apparaissent en production
- Équité et prévention des abus
- Sources
- FAQ
Comment les principaux algorithmes de limitation de débit se comparent-ils ?
Cinq algorithmes couvrent presque tous les cas de production. Chacun se situe à un point différent entre coût mémoire, tolérance aux rafales et précision. Le tutoriel Redis sur la limitation de débit compare ces cinq algorithmes, et le tableau ci-dessous suit sa structure.
| Algorithme | État par client | Précision | Comportement face aux rafales | Usage typique |
|---|---|---|---|---|
| Fenêtre fixe | Un compteur | Approximative | Autorise jusqu’à 2 fois la limite aux frontières de fenêtre | API simples, limitation des tentatives de connexion |
| Journal de fenêtre glissante | Ensemble trié d’horodatages | Exacte | Aucune rafale | API à forte valeur, pistes d’audit |
| Compteur à fenêtre glissante | Deux compteurs | Presque exacte | Frontières lissées | Limites d’API à usage général |
| Seau à jetons | Hash avec nombre de jetons et heure de recharge | Exacte | Autorise des rafales contrôlées | Trafic par rafales avec plafond de débit moyen |
| Seau percé | Hash avec un ou deux champs | Exacte | Aucune rafale, écoulement régulier | Contrôle ou mise en forme du trafic devant un backend fragile |
Choisissez selon la contrainte principale. La fenêtre fixe est la moins coûteuse à exécuter. Le journal de fenêtre glissante est exact, mais sa mémoire croît avec le volume de requêtes. Le compteur à fenêtre glissante donne des résultats presque exacts avec une mémoire constante. Le seau à jetons convient aux API destinées aux développeurs qui ont besoin de marge pour les rafales, et le seau percé convient aux files d’attente placées devant des backends sensibles au débit.
Notes d’implémentation pour chaque algorithme
Chaque algorithme exige une structure d’état spécifique et a son propre coût d’exécution. Choisir un algorithme revient donc à choisir une structure de données.
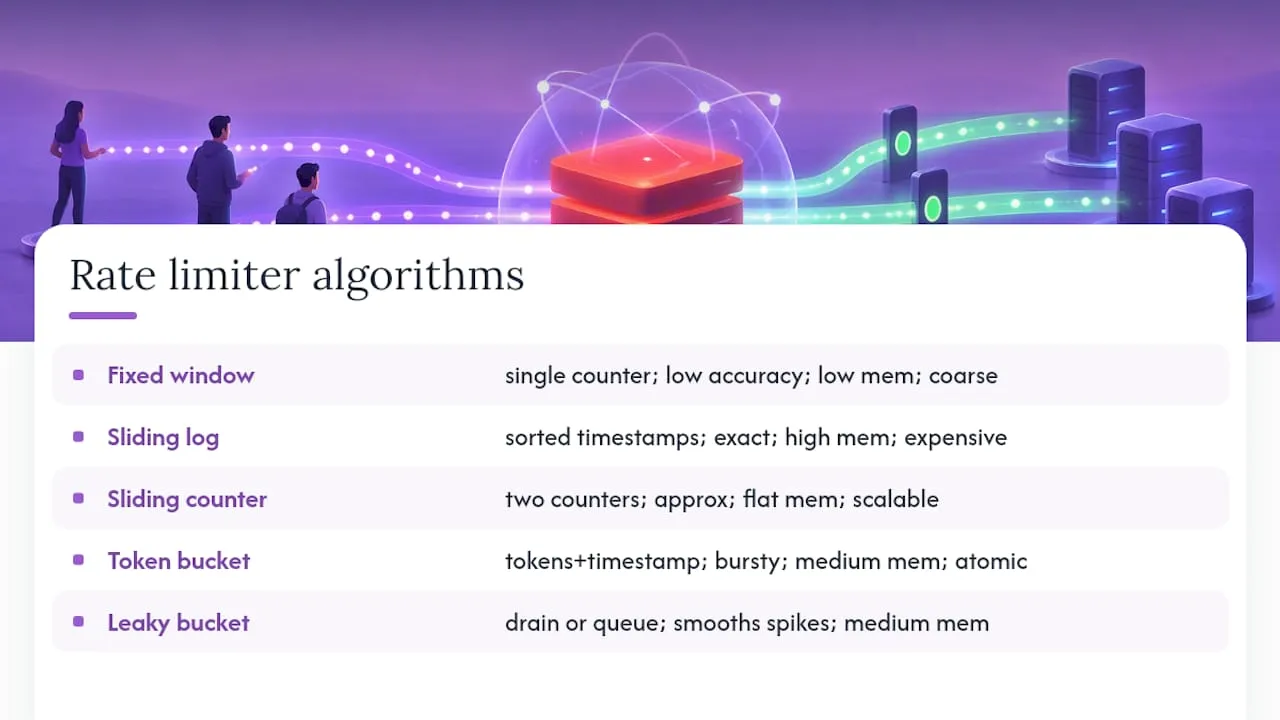
La fenêtre fixe stocke un compteur par client et par intervalle de temps. Elle incrémente le compteur à chaque requête et le remet à zéro lorsque l’intervalle change. Sa faiblesse tient à la frontière. Avec une limite de 100 requêtes par minute, un client peut en envoyer 100 à 12:00:59, puis 100 autres à 12:01:00. Cela fait 200 requêtes en deux secondes. Réservez donc la fenêtre fixe aux limites grossières et peu risquées.
Le journal de fenêtre glissante conserve, pour chaque client, un ensemble trié d’horodatages de requêtes, et supprime à chaque contrôle les entrées plus anciennes que la fenêtre. Il est exact, car il compte les requêtes réelles. Sa mémoire croît avec le volume de requêtes, ce qui le rend coûteux pour les clients à fort trafic.
Le compteur à fenêtre glissante stocke deux compteurs : un pour la fenêtre courante et un pour la fenêtre précédente. Il pondère le compte de la fenêtre précédente par la part de cette fenêtre qui chevauche encore la fenêtre glissante. Prenons une limite de 100 par minute, 80 requêtes dans la minute précédente et 30 jusqu’ici dans la minute courante, à 25 % de la minute courante. L’estimation est de 80 × 0,75 + 30 = 90. Le client dispose encore d’environ 10 requêtes.
Cloudflare décrit cette approche pour sa limitation de débit. Elle n’exige que deux nombres par compteur. Dans une analyse de 400 millions de requêtes provenant de 270 000 sources distinctes, 0,003 % des requêtes ont été à tort autorisées ou limitées, selon Cloudflare.
Le seau à jetons stocke un nombre de jetons et un horodatage de dernière recharge par client. À chaque requête, vous calculez les jetons gagnés depuis le dernier contrôle, vous plafonnez le total à la capacité du seau, puis vous retirez un jeton s’il en reste. La recharge et la consommation doivent être atomiques. Sinon, deux requêtes concurrentes peuvent lire le même nombre de jetons et réussir toutes les deux, alors qu’une seule devrait réussir.
Le seau percé existe sous deux formes. La forme de contrôle rejette les requêtes qui dépassent le débit d’écoulement. La forme de mise en forme les place en file d’attente pour un traitement ultérieur. Utilisez-la lorsque le point de terminaison se trouve devant une base de données ou un service tiers incapable d’absorber les pics.
Astuce : Regroupez la recharge et la consommation dans un seul script Lua au lieu d’appels GET et SET séparés. Une séquence lecture-puis-écriture en deux allers-retours est précisément la condition de concurrence que les scripts atomiques servent à empêcher.
Comment construire un limiteur qui fonctionne entre instances ?
Conservez les compteurs dans Redis et rendez chaque mise à jour atomique. Un limiteur qui fonctionne dans un seul processus mais échoue sous concurrence est pire que pas de limiteur, car il donne un faux sentiment de protection.
- Stockez les compteurs dans Redis afin que chaque instance de l’application lise et écrive le même état.
- Utilisez des scripts Redis Lua pour regrouper les étapes de lecture, de recharge et de consommation en une seule opération atomique. Le tutoriel Redis explique pourquoi : avec des commandes séparées, des requêtes concurrentes peuvent lire le même état, décider chacune qu’elle est autorisée, puis écrire toutes deux leur résultat.
- Pour les services à fort volume, agrégez les comptes localement par instance ou par point de présence avant de les synchroniser avec un magasin central. Cela évite un appel à Redis à chaque requête.
- Ajoutez un seau percé au niveau de la passerelle, par exemple dans NGINX, comme mur extérieur contre le trafic abusif. Conservez les limites plus fines par clé dans l’application.
- Décidez entre fail-open et fail-closed pour chaque point de terminaison, avant qu’un incident ne vous impose le choix.
Passez en fail-open sur les points de terminaison publics à forte lecture, afin qu’une panne de Redis ne mette pas toute l’API hors service. Passez en fail-closed sur les points d’authentification et de paiement, où un trafic illimité représente le risque le plus grand.
Astuce : Journalisez séparément chaque événement fail-open, à part du trafic normal. Une panne de Redis qui désactive silencieusement vos limites n’apparaît souvent que lors d’une revue d’incident.
Quel algorithme convient à quel point de terminaison ?
Vérifiez quatre points avant d’écrire du code. Combien de mémoire pouvez-vous consacrer à chaque client ? Les rafales sont-elles légitimes, ou constituent-elles une menace ? Le système en aval est-il fragile ? Des estimations sont-elles acceptables à la place de comptes exacts ?
| Type de point de terminaison | Algorithme suggéré | Raison |
|---|---|---|
| API publiques pour développeurs | Compteur à fenêtre glissante ou seau à jetons | Les deux tolèrent des rafales raisonnables sans le surcoût d’un comptage exact |
| Paiement et authentification | Journal de fenêtre glissante, ou un fail-closed par défaut | Comptes exacts, et rejeter est plus sûr que laisser passer un trafic suspect |
| Flux limités par un service en aval | Seau percé | Le débit de sortie ne dépasse jamais ce que le backend peut absorber |
| Trafic interne à fort volume et faible risque | Fenêtre fixe | Implémentation la plus simple, et les rafales aux frontières sont acceptables |
Si vous ne pouvez pas dire ce qui se passe lorsque Redis est injoignable, la conception n’est pas terminée, quel que soit l’algorithme choisi.
Comment indiquer aux clients leurs limites ?
Envoyez l’état actuel des limites dans les en-têtes de réponse, et envoyez Retry-After avec chaque 429. Les clients ne doivent pas avoir à deviner où ils en sont.
Le groupe de travail HTTP API de l’IETF standardise ces en-têtes dans le brouillon d’Internet RateLimit header fields for HTTP. Dans la révision actuelle (brouillon 11, mai 2026), le champ RateLimit-Policy décrit le quota, et le champ RateLimit indique ce qui reste :
RateLimit-Policy: "default";q=100;w=60RateLimit: "default";r=50;t=30Ici, q est le quota, w la fenêtre en secondes, r le quota restant et t le nombre de secondes avant la réinitialisation de la fenêtre. Cela remplace les anciennes révisions du brouillon, qui utilisaient des champs séparés RateLimit-Limit, RateLimit-Remaining et RateLimit-Reset. Beaucoup d’API envoient encore les en-têtes préfixés par le fournisseur X-RateLimit-*, qui sont antérieurs au brouillon. Comme le brouillon n’est pas définitif, vérifiez la révision courante avant de vous engager sur un format.
Une requête rejetée doit utiliser le statut 429, que la RFC 6585 définit comme Too Many Requests. La réponse peut inclure un en-tête Retry-After indiquant le nombre de secondes à attendre, comme dans l’exemple de la RFC :
HTTP/1.1 429 Too Many RequestsRetry-After: 3600En pratique, suivez ces règles :
- Envoyez les en-têtes de limite sur chaque réponse, et pas seulement sur les rejets.
- Envoyez
Retry-Afterchaque fois que vous rejetez une requête avec un 429. - Considérez les en-têtes comme des indications. Le brouillon précise que les clients ne doivent pas supposer qu’un quota disponible positif garantit que les requêtes suivantes seront servies.
- Côté client, utilisez un backoff exponentiel avec jitter plutôt qu’un délai fixe, pour que les nouvelles tentatives n’arrivent pas en vagues synchronisées.
Régler les taux de recharge, la capacité et les alertes
Partez du trafic mesuré, et non d’une supposition. Extrayez de vos métriques les requêtes par seconde p95 et p99 par client, puis réglez le taux de recharge un peu au-dessus du p99 soutenu, afin qu’un usage normal ne déclenche jamais le limiteur. Dimensionnez la capacité du seau pour absorber environ 5 à 10 secondes de trafic p99. Ce sont des valeurs de départ, et non une norme.
Par exemple, si un client a un p99 de 20 requêtes par seconde, un taux de recharge de 24 par seconde et une capacité de 200 jetons autorisent une rafale de 200 requêtes. Après cette rafale, le seau a besoin de 200 / 24, soit environ 8,3 secondes, pour se recharger complètement.
Surveillez ces signaux après la mise en production du limiteur :
- Le taux de 429 et la part des requêtes limitées dans l’ensemble du trafic, et pas seulement les nombres bruts.
- La latence du trafic limité et celle du trafic non limité, suivies séparément, car une hausse de la première précède souvent une hausse de la seconde.
- Les échecs ou délais de commandes Redis liés au limiteur, car une panne silencieuse neutralise tout le système.
Déployez d’abord les changements de limite sur une petite part du trafic, puis élargissez-les une fois le taux de 429 et la latence stables.
Astuce : Lorsque vous durcissez une limite, annoncez le changement et les nouveaux en-têtes aux consommateurs de l’API avant la mise en production. Un 429 inattendu, sans contexte, génère plus de tickets de support que l’abus qu’il devait arrêter.
Où ces motifs apparaissent en production
La plupart des architectures de production répartissent l’application des limites entre deux couches.
- Périphérie : une configuration NGINX à seau percé absorbe le trafic abusif et le scraping évident avant qu’ils n’atteignent les serveurs d’application.
- Application : un script Redis Lua qui implémente un seau à jetons ou un compteur à fenêtre glissante applique les limites par clé, généralement en fail-open sur les points de terminaison en lecture seule.
- API publiques pour développeurs : compteur à fenêtre glissante ou seau à jetons, réglé selon le niveau d’abonnement du client.
- Points de terminaison d’authentification : limites strictes à faible capacité, souvent en fail-closed.
- Traitement des webhooks : seau percé ou file d’attente avec limiteur, car les nouvelles tentatives du service émetteur doivent être lissées plutôt que rejetées net.
Équité et prévention des abus
La limitation de débit décide quelles requêtes sont servies lorsque la demande dépasse la capacité, et cette décision touche de vrais utilisateurs. Une limite trop stricte bloque les clients légitimes pendant un pic de trafic. Une limite trop souple laisse quelques clients abusifs dégrader le service pour tout le monde.
Publiez vos limites dans la documentation de l’API, car une limitation non documentée paraît arbitraire. Appliquez les limites de façon cohérente entre clients similaires. Précisez dans vos conditions ce qui constitue un trafic abusif, comme le bourrage d’identifiants ou le scraping, par opposition à un usage à fort volume par un client payant.
Pour les plateformes multi-locataires, isolez les limites par locataire. Le pic d’un client, qu’il soit légitime ou malveillant, ne peut alors pas épuiser le quota d’un autre locataire sur la même infrastructure.
Sources
- Build 5 Rate Limiters with Redis: Fixed Window, Sliding Window, Token Bucket, and Leaky Bucket
- RateLimit header fields for HTTP (brouillon IETF)
- Counting things: a lot of different things (Cloudflare)
- RFC 6585: Additional HTTP Status Codes
Recommandé
Questions fréquentes
Combinez un algorithme adapté au profil de trafic avec une application atomique. Un compteur à fenêtre glissante convient aux API générales, et un seau à jetons aux clients à rafales. L’application atomique signifie que des requêtes concurrentes ne peuvent pas contourner la limite. Des limites à la périphérie, complétées par des limites par clé dans l’application, ajoutent une seconde couche, comme dans l’approche de Cloudflare.
Stockez les compteurs ou l’état des jetons dans un magasin partagé comme Redis, et regroupez les étapes de lecture, de recharge et de consommation dans un seul script Lua atomique. Renvoyez les en-têtes RateLimit sur chaque réponse, et l’en-tête Retry-After sur les rejets, afin que les clients sachent comment se comporter.
Vérifiez votre budget mémoire, votre tolérance aux rafales et la fragilité des systèmes en aval. Associez ensuite un algorithme à ces contraintes : compteur à fenêtre glissante ou seau à jetons pour les API publiques, journal de fenêtre glissante ou fail-closed par défaut pour les points de terminaison sensibles. Réglez le taux de recharge à partir du trafic p99 mesuré.
La limitation de débit d’API plafonne le nombre de requêtes qu’un client peut effectuer sur une période donnée. Elle protège le service contre la surcharge et assure une répartition équitable entre les clients. Les serveurs indiquent en général la limite et le quota restant dans les en-têtes de réponse, ce que standardise le brouillon IETF sur les en-têtes RateLimit.
Comment nous rédigeons ces articles
Prêt à le construire vous-même ? Obtenir votre clé API — essai de 7 jours, sans carte bancaire — ou consultez API Blockchain pour la référence complète des endpoints.