Strategie di rate limiting per API per sviluppatori
Confronto tra limiter fixed window, sliding window, token bucket e leaky bucket, implementazione atomica con Redis Lua e invio degli header RateLimit.
Verificato da Maurice Sobiera
Il rate limiting delle API limita le richieste che un client può inviare in un periodo, così che un solo client non sovraccarichi il servizio. Per la maggior parte delle API pubbliche un contatore a finestra scorrevole è una buona scelta: è quasi esatto e usa memoria costante per client. Per consentire picchi si usa un token bucket.
In breve:
- Un contatore a finestra scorrevole bilancia precisione e memoria, e si adatta alle API pubbliche generiche con traffico elevato.
- Gli script Lua di Redis rendono atomici i passaggi di lettura, refill e consumo, così che le richieste concorrenti non entrano in competizione.
- Un tasso di refill appena superiore al traffico p99 normale e una capacità pari a 5-10 secondi di picco sono valori di partenza ragionevoli.
- Si comunicano i limiti ai client con gli header RateLimit, e si invia Retry-After in ogni risposta 429.
- I limiti si applicano al bordo e nell’applicazione, e per ogni endpoint si decide che cosa succede quando Redis non è raggiungibile.
Indice
- Come si confrontano gli algoritmi principali di rate limiting?
- Note di implementazione per ogni algoritmo
- Come si costruisce un limiter che funziona su più istanze?
- Quale algoritmo si adatta a quale endpoint?
- Come si comunicano ai client i loro limiti?
- Impostare tassi di refill, capacità e avvisi
- Dove compaiono questi schemi in produzione?
- Equità e prevenzione degli abusi
- Fonti
- FAQ
Come si confrontano gli algoritmi principali di rate limiting?
Cinque algoritmi coprono quasi tutti i casi di produzione. Ciascuno si colloca in un punto diverso tra costo di memoria, tolleranza ai picchi e precisione. Il tutorial Redis sul rate limiting confronta gli stessi cinque, e la tabella seguente ne segue la struttura.
| Algoritmo | Stato per client | Precisione | Comportamento con i picchi | Uso tipico |
|---|---|---|---|---|
| Fixed window | Un contatore | Approssimata | Consente fino al doppio del limite ai confini della finestra | Limiti API semplici, throttling del login |
| Sliding window log | Sorted set di timestamp | Esatta | Nessun picco | API di alto valore, tracce di audit |
| Sliding window counter | Due contatori | Quasi esatta | Confini smussati | Limiti API di uso generale |
| Token bucket | Hash con conteggio dei token e tempo di refill | Esatta | Consente picchi controllati | Traffico a raffiche con un limite di velocità medio |
| Leaky bucket | Hash con uno o due campi | Esatta | Nessun picco, svuotamento costante | Controllo o modellamento del traffico davanti a un backend fragile |
Si sceglie in base al vincolo principale. Il fixed window è il più economico da far girare. Il sliding window log è esatto, ma la sua memoria cresce con il volume delle richieste. Il sliding window counter dà risultati quasi esatti con memoria costante. Il token bucket si adatta alle API rivolte agli sviluppatori che richiedono margine per i picchi, e il leaky bucket si adatta alle code davanti a backend sensibili alla velocità.
Note di implementazione per ogni algoritmo
Ogni algoritmo richiede una forma di stato specifica e ha un costo di esecuzione proprio, quindi scegliere un algoritmo significa in realtà scegliere una struttura dati.
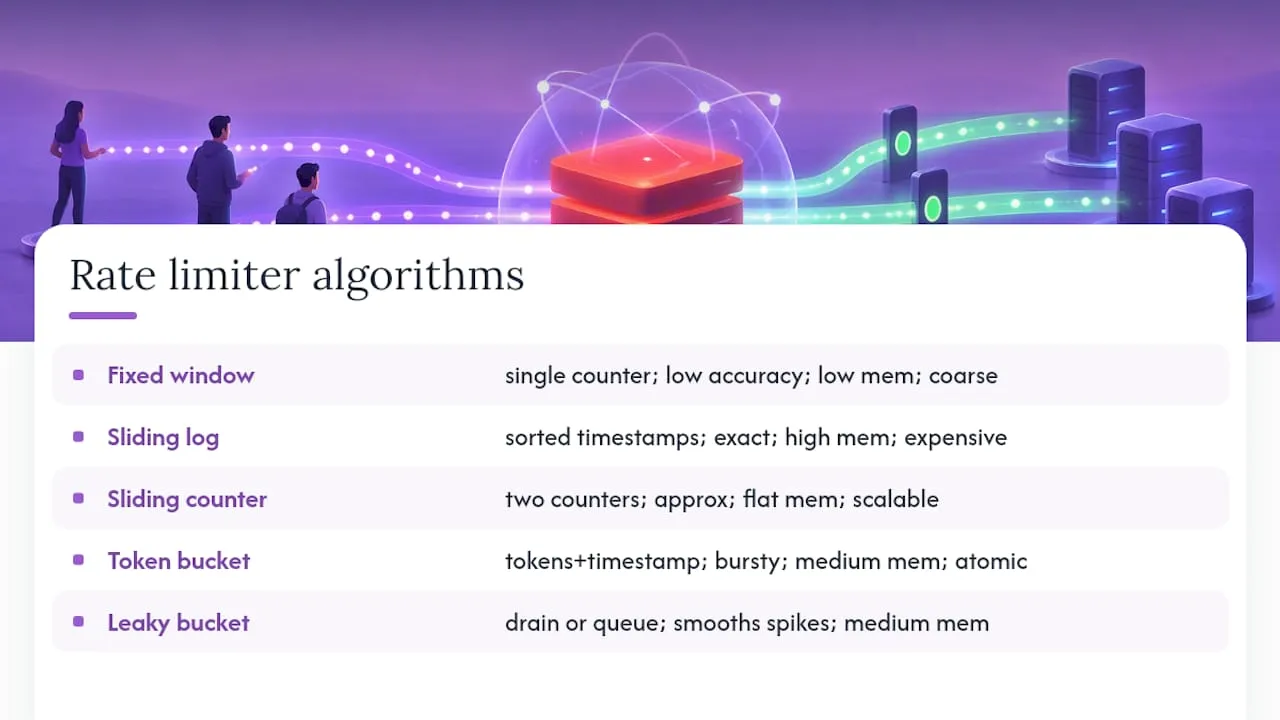
Il fixed window conserva un contatore per client e per intervallo di tempo. Incrementa a ogni richiesta e si azzera quando l’intervallo cambia. Il punto debole è il confine. Con un limite di 100 richieste al minuto, un client può inviarne 100 alle 12:00:59 e altre 100 alle 12:01:00. Sono 200 richieste in due secondi, quindi il fixed window va usato solo per limiti grossolani a basso rischio.
Il sliding window log mantiene per ogni client un sorted set di timestamp delle richieste ed elimina le voci più vecchie della finestra a ogni controllo. È esatto perché conta le richieste reali. La memoria cresce con il volume delle richieste, il che lo rende costoso per i client con traffico elevato.
Il sliding window counter memorizza due contatori, uno per la finestra corrente e uno per quella precedente. Pesa il conteggio della finestra precedente in base alla porzione di quella finestra che si sovrappone ancora alla finestra scorrevole. Con un limite di 100 al minuto, 80 richieste nel minuto precedente e 30 finora nel minuto corrente, cioè il 25 per cento del minuto corrente trascorso, la stima è 80 × 0,75 + 30 = 90. Al client restano circa 10 richieste.
Cloudflare descrive questo approccio per il proprio rate limiting. Servono solo due numeri per contatore. In un’analisi di 400 milioni di richieste provenienti da 270.000 sorgenti distinte, secondo Cloudflare lo 0,003 per cento delle richieste è stato consentito o limitato per errore.
Il token bucket memorizza per ogni client un conteggio di token e un timestamp dell’ultimo refill. A ogni richiesta si calcolano i token guadagnati dall’ultimo controllo, si limita il totale alla capacità del bucket e si sottrae un token se disponibile. Refill e consumo devono avvenire in modo atomico. Altrimenti due richieste concorrenti possono leggere lo stesso conteggio di token, e riuscire entrambe quando dovrebbe riuscirne solo una.
Il leaky bucket esiste in due forme. La forma di policing scarta le richieste che superano la velocità di svuotamento. La forma di shaping le accoda per un’elaborazione successiva. Lo si usa quando l’endpoint si trova davanti a un database o a un servizio di terze parti che non può assorbire i picchi.
Consiglio pratico: Racchiudete refill e consumo in un unico script Lua invece di usare chiamate GET e SET separate. Una sequenza di lettura seguita da scrittura su due round trip è la race condition che gli script atomici servono a prevenire.
Come si costruisce un limiter che funziona su più istanze?
I contatori vanno conservati in Redis e ogni aggiornamento deve essere atomico. Un limiter che funziona in un singolo processo ma cede sotto concorrenza è peggiore di nessun limiter, perché dà un falso senso di protezione.
- Memorizzare i contatori in Redis, così che ogni istanza dell’applicazione legga e scriva lo stesso stato.
- Usare script Lua di Redis per combinare i passaggi di lettura, refill e consumo in un’unica operazione atomica. Il tutorial Redis spiega il motivo: con comandi separati, richieste concorrenti possono leggere lo stesso stato, decidere entrambe di essere consentite e scrivere entrambe il risultato.
- Per i servizi ad alto volume, aggregare i conteggi localmente per istanza o per point of presence prima di sincronizzarli con un archivio centrale. Così si evita una chiamata a Redis a ogni richiesta.
- Aggiungere a livello di gateway un leaky bucket, per esempio in NGINX, come barriera esterna contro il traffico abusivo. I limiti più fini per chiave restano nell’applicazione.
- Decidere tra fail-open e fail-closed per ogni endpoint prima che un incidente imponga la decisione.
Il fail-open va usato sugli endpoint pubblici a prevalenza di lettura, così che un’interruzione di Redis non metta fuori servizio l’intera API. Il fail-closed va usato sugli endpoint di autenticazione e di pagamento, dove il traffico senza limiti è il rischio maggiore.
Consiglio pratico: Registrate ogni evento di fail-open separatamente dal traffico normale. Un’interruzione di Redis che disattiva silenziosamente i limiti tende a emergere solo in una revisione post-incidente.
Quale algoritmo si adatta a quale endpoint?
Prima di scrivere il codice si verificano quattro aspetti. Quanta memoria si può spendere per ogni client? I picchi sono legittimi o una minaccia? Quanto è fragile il sistema a valle? Sono accettabili stime invece di conteggi esatti?
| Tipo di endpoint | Algoritmo suggerito | Motivo |
|---|---|---|
| API pubbliche per sviluppatori | Sliding window counter o token bucket | Entrambi tollerano picchi ragionevoli senza il costo dei conteggi esatti |
| Pagamenti e autenticazione | Sliding window log, oppure un default fail-closed | Conteggi esatti, e rifiutare è più sicuro che lasciar passare traffico sospetto |
| Flussi limitati da un servizio a valle | Leaky bucket | La velocità in uscita non supera mai ciò che il backend può gestire |
| Traffico interno ad alto volume e basso rischio | Fixed window | Implementazione più semplice, e i picchi ai confini sono accettabili |
Se non si sa dire che cosa succede quando Redis non è raggiungibile, il progetto non è completo, qualunque algoritmo si sia scelto.
Come si comunicano ai client i loro limiti?
Lo stato attuale del limite va inviato negli header di risposta, e in ogni 429 va inviato Retry-After. I client non devono indovinare la propria situazione.
La IETF HTTP API working group sta standardizzando gli header nella bozza Internet-Draft RateLimit header fields for HTTP. Nella revisione attuale (draft 11, maggio 2026), il campo RateLimit-Policy descrive la quota e il campo RateLimit riporta quanto resta:
RateLimit-Policy: "default";q=100;w=60RateLimit: "default";r=50;t=30Qui q è la quota, w è la finestra in secondi, r è la quota rimanente e t sono i secondi che mancano al reset della finestra. Questo sostituisce le revisioni precedenti della bozza, che usavano campi separati RateLimit-Limit, RateLimit-Remaining e RateLimit-Reset. Molte API inviano ancora gli header con prefisso del fornitore X-RateLimit-*, che precedono la bozza. Poiché la bozza non è definitiva, si verifica la revisione attuale prima di adottare un formato.
Una richiesta respinta deve usare lo stato 429, che la RFC 6585 definisce come Too Many Requests. La risposta può includere un header Retry-After con il numero di secondi da attendere, come nell’esempio della RFC:
HTTP/1.1 429 Too Many RequestsRetry-After: 3600Nella pratica valgono queste regole:
- Inviare gli header dei limiti in ogni risposta, non solo nei rifiuti.
- Inviare
Retry-Afterogni volta che si respinge con un 429. - Trattare gli header come indicazioni. La bozza precisa che i client non devono presumere che una quota disponibile positiva garantisca che le richieste successive saranno servite.
- Sul client, usare un backoff esponenziale con jitter invece di un ritardo fisso, così che i tentativi non arrivino in ondate sincronizzate.
Impostare tassi di refill, capacità e avvisi
Si parte dal traffico misurato, non da una stima. Si raccolgono da metriche i valori p95 e p99 delle richieste al secondo per client, e si imposta il tasso di refill un po’ sopra il p99 sostenuto, così che l’uso normale non attivi mai il limiter. La capacità del bucket va dimensionata per assorbire circa 5-10 secondi di traffico p99. Sono valori di partenza, non uno standard.
Per esempio, se un client ha un p99 di 20 richieste al secondo, un tasso di refill di 24 al secondo e una capacità di 200 token consentono un picco di 200 richieste. Dopo quel picco, il bucket impiega 200 / 24, circa 8,3 secondi, per riempirsi completamente.
Dopo l’attivazione del limiter, si monitorano questi segnali:
- Il tasso di 429 e la quota di richieste limitate sul totale, non solo i conteggi grezzi.
- La latenza del traffico limitato e di quello non limitato, misurata separatamente, perché un aumento della prima spesso precede un aumento della seconda.
- I guasti o i timeout dei comandi Redis legati al limiter, perché un guasto silenzioso annulla l’intero sistema.
Le modifiche ai limiti vanno distribuite prima a una piccola quota di traffico, e poi estese quando il tasso di 429 e la latenza risultano stabili.
Consiglio pratico: Quando si stringe un limite, si annunciano la modifica e i nuovi header ai consumatori dell’API prima del rilascio. Un 429 a sorpresa senza contesto genera più ticket di supporto di quanti abusi avrebbe dovuto fermare.
Dove compaiono questi schemi in produzione?
La maggior parte degli stack di produzione divide l’applicazione dei limiti su due livelli.
- Bordo: una configurazione leaky bucket di NGINX assorbe il traffico abusivo e lo scraping evidente prima che raggiunga i server applicativi.
- Applicazione: uno script Lua di Redis che implementa token bucket o sliding window counter applica limiti per chiave, di solito con fail-open sugli endpoint di sola lettura.
- API pubbliche per sviluppatori: sliding window counter o token bucket, calibrati sul livello del piano del client.
- Endpoint di autenticazione: limiti severi e di bassa capacità, spesso con fail-closed.
- Elaboratori di webhook: leaky bucket o un limiter basato su coda, perché i nuovi tentativi del servizio mittente richiedono un livellamento e non un rifiuto secco.
Equità e prevenzione degli abusi
Il rate limiting decide quali richieste vengono servite quando la domanda supera la capacità, e questa decisione incide su utenti reali. Un limite troppo severo esclude i clienti legittimi durante un picco di traffico. Un limite troppo largo permette a pochi client abusivi di degradare il servizio per tutti.
Pubblicate i limiti nella documentazione dell’API, perché un throttling non documentato sembra arbitrario. Applicate i limiti in modo coerente tra client simili. Indicate nei vostri termini che cosa conta come traffico abusivo, come il credential stuffing o lo scraping, distinguendolo dall’uso ad alto volume da parte di un cliente pagante.
Per le piattaforme multi-tenant, isolate i limiti per tenant. Il picco di un cliente, legittimo o malevolo, non può così esaurire la quota di un altro tenant sulla stessa infrastruttura.
Fonti
- Build 5 Rate Limiters with Redis: Fixed Window, Sliding Window, Token Bucket, and Leaky Bucket
- RateLimit header fields for HTTP (IETF draft)
- Counting things: a lot of different things (Cloudflare)
- RFC 6585: Additional HTTP Status Codes
Consigliati
Domande frequenti
Si combina un algoritmo adatto allo schema di traffico con un’applicazione atomica. Il sliding window counter si adatta alle API generiche, e il token bucket ai client con traffico a raffiche. Un’applicazione atomica significa che le richieste concorrenti non possono aggirare il limite. I limiti al bordo più i limiti applicativi per chiave aggiungono un secondo livello, come nell’approccio di Cloudflare.
Si memorizzano i contatori o lo stato dei token in un archivio condiviso come Redis, e si racchiudono i passaggi di lettura, refill e consumo in un unico script Lua atomico. Si restituiscono gli header RateLimit in ogni risposta e l’header Retry-After nei rifiuti, così che i client sappiano come comportarsi.
Si verificano il budget di memoria, la tolleranza ai picchi e la fragilità dei sistemi a valle. Poi si abbina un algoritmo a questi vincoli: sliding window counter o token bucket per le API pubbliche, sliding window log o un default fail-closed per gli endpoint sensibili. Il tasso di refill si calibra sul traffico p99 misurato.
Il rate limiting delle API limita il numero di richieste che un client può effettuare in un dato periodo. Protegge il servizio dal sovraccarico e mantiene un uso equo tra i client. I server di solito comunicano il limite e la quota rimanente negli header di risposta, che la bozza IETF sugli header RateLimit sta standardizzando.
Come scriviamo questi articoli
Pronto a costruirlo da solo? Ottieni la tua API key — prova di 7 giorni, senza carta — oppure consulta Blockchain API per il riferimento completo degli endpoint.