面向开发者的 API 限流策略:五种算法与 Redis Lua 实现
比较固定窗口、滑动窗口、令牌桶和漏桶等限流器,使用 Redis Lua 以原子方式实现它们,并返回 RateLimit 响应头。文中还给出各算法的状态结构、速率与容量的设定方法、需要监控的指标,以及公平性和滥用防护的做法。
审核: Maurice Sobiera
API 限流限制客户端在一段时间内可以发送的请求数量,使单个客户端无法压垮服务,也不会挤占其他客户端的资源。对于大多数公开 API,滑动窗口计数器是很好的默认选择:它的结果接近精确,且每个客户端占用的内存恒定。若您希望允许突发流量,请使用令牌桶。
TL;DR:
- 滑动窗口计数器在准确性和内存之间取得平衡,适合流量较大的通用公开 API。
- Redis Lua 脚本可以把读取、补充和消耗三个步骤变为原子操作,因此并发请求不会产生竞态。
- 补充速率略高于正常的 p99 流量,容量相当于 5 到 10 秒的突发流量,是比较合理的起始值。
- 通过 RateLimit 响应头告知客户端其限额,并在每个 429 响应中发送 Retry-After。
- 在边缘和应用两层执行限制,并为每个端点决定 Redis 宕机时的处理方式。
目录
- 主流限流算法如何比较?
- 各算法的实现要点
- 如何构建可跨实例工作的限流器?
- 哪种算法适合哪个端点?
- 如何告知客户端其限额?
- 如何设定补充速率、容量与告警
- 这些模式在生产环境中的应用
- 公平性与滥用防护
- 来源
- 常见问题
主流限流算法如何比较?
五种算法几乎覆盖了所有生产场景。它们各自处于内存成本、突发容忍度和准确性之间的不同位置。Redis 限流教程比较了同样这五种算法,下表沿用其结构。
| 算法 | 每个客户端的状态 | 准确性 | 突发行为 | 典型用途 |
|---|---|---|---|---|
| 固定窗口 | 一个计数器 | 近似 | 在窗口边界处最多允许两倍限额 | 简单的 API 限额、登录节流 |
| 滑动窗口日志 | 时间戳的有序集合 | 精确 | 无突发 | 高价值 API、审计跟踪 |
| 滑动窗口计数器 | 两个计数器 | 接近精确 | 边界被平滑 | 通用 API 限额 |
| 令牌桶 | 含令牌数和补充时间的哈希 | 精确 | 允许受控的突发 | 有突发特征、且需限制平均速率的流量 |
| 漏桶 | 含一到两个字段的哈希 | 精确 | 无突发,匀速排空 | 在脆弱后端前面做流量管控或整形 |
根据主要约束来选择。固定窗口运行成本最低。滑动窗口日志是精确的,但内存会随请求量增长。滑动窗口计数器以恒定内存提供接近精确的结果。令牌桶适合需要突发余量的面向开发者的 API,漏桶则适合放在对速率敏感的后端前面排队。
各算法的实现要点
每种算法都需要特定的状态结构,并有各自的运行成本,因此选择算法实际上就是选择数据结构。
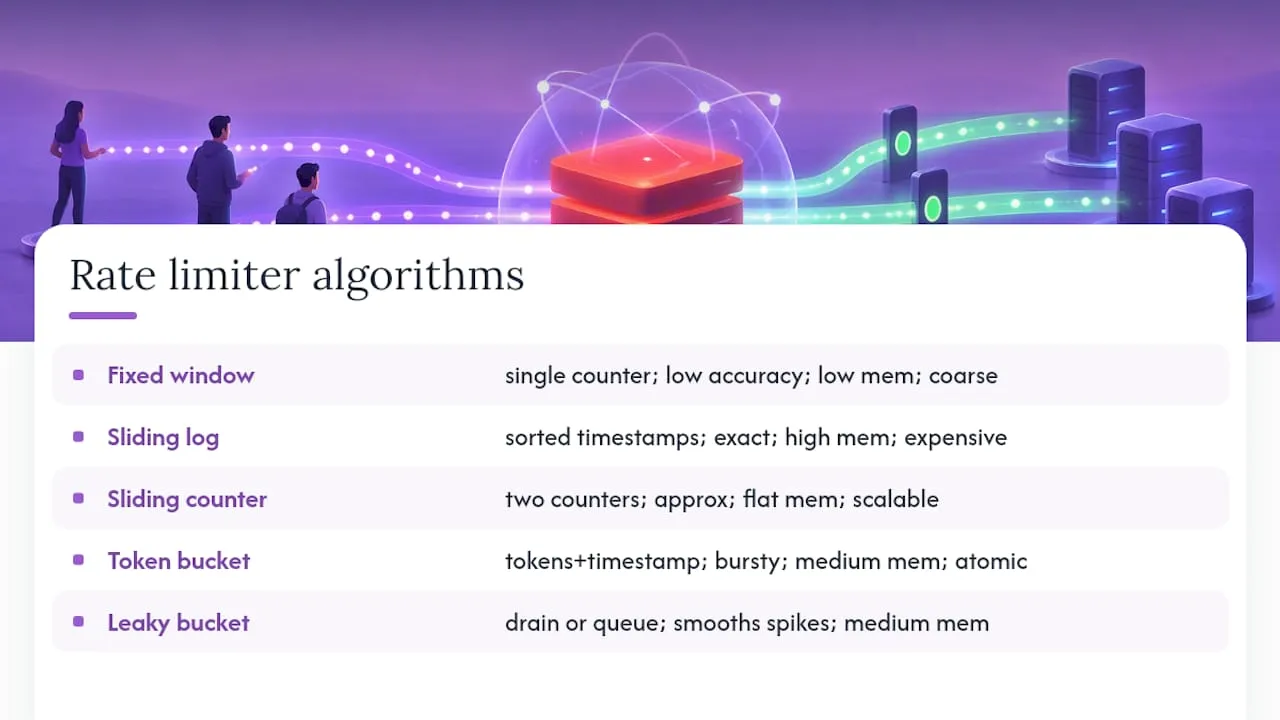
固定窗口为每个客户端和每个时间桶保存一个计数器。每次请求递增,窗口滚动时重置。其弱点在于边界。以每分钟 100 次请求为限,客户端可以在 12:00:59 发送 100 次请求,又在 12:01:00 发送 100 次。这意味着两秒内有 200 次请求,因此固定窗口只适合粗粒度、低风险的限额。
滑动窗口日志为每个客户端保存一个请求时间戳的有序集合,并在每次检查时删除超出窗口的条目。由于它统计的是真实请求,因此结果是精确的。内存会随请求量增长,这使它对高流量客户端的开销很大。
滑动窗口计数器保存两个计数器,一个对应当前窗口,一个对应上一个窗口。它按上一窗口仍与滑动窗口重叠的比例对上一窗口的计数加权。以每分钟 100 次为限,上一分钟有 80 次请求,当前分钟已有 30 次,当前分钟已过 25%。估算值为 80 × 0.75 + 30 = 90,客户端大约还剩 10 次请求。
Cloudflare 在其限流中描述了这种方法。它每个计数器只需要两个数字。根据 Cloudflare 的分析,在来自 27 万个不同来源的 4 亿次请求中,有 0.003% 的请求被错误地放行或限流。
令牌桶为每个客户端保存一个令牌数和一个最近补充时间戳。每次请求时,您先计算自上次检查以来获得的令牌数,将总数限制在桶的容量之内,然后在有可用令牌时扣减一个。补充与消耗必须是原子的。否则,两个并发请求可能读到相同的令牌数,而只应有一个成功时两个都会成功。
漏桶有两种形式。管控形式会丢弃超过排空速率的请求;整形形式则把它们排队,稍后处理。当端点位于无法吸收峰值的数据库或第三方服务前面时,可以使用它。
**专业提示:**把补充和消耗放进同一个 Lua 脚本,而不是分开的 GET 和 SET 调用。跨两次往返的“先读后写”正是原子脚本要防止的竞态条件。
如何构建可跨实例工作的限流器?
把计数器保存在 Redis 中,并让每次更新都是原子的。一个只在单个进程中有效、在并发下失效的限流器,比没有限流器更糟,因为它会给人一种虚假的保护感。
- 将计数器存入 Redis,使每个应用实例读写的是同一份状态。
- 使用 Redis Lua 脚本,把读取、补充和消耗三个步骤合并为一次原子操作。Redis 教程解释了原因:若使用分开的命令,并发请求可能读到相同的状态,都判定为允许,然后都写回。
- 对于高流量服务,在每个实例或每个接入点本地汇总计数,再同步到中心存储。这样可以避免每个请求都调用一次 Redis。
- 在网关层添加一个漏桶,例如在 NGINX 中配置,作为抵御滥用流量的外层防线。更精细的按键限额则保留在应用中。
- 在事故迫使您做出决定之前,先为每个端点确定是失败放行(fail-open)还是失败拒绝(fail-closed)。
对于读取密集的公开端点,应失败放行,这样 Redis 故障不会让整个 API 瘫痪。对于认证和支付端点,应失败拒绝,因为不受限的流量风险更大。
**专业提示:**把每一次失败放行事件与正常流量分开记录。Redis 故障若悄无声息地关闭了您的限额,通常只会在事故复盘时才被发现。
哪种算法适合哪个端点?
在编写代码之前,先检查四件事。每个客户端可以花费多少内存?突发流量是正当需求还是威胁?下游系统有多脆弱?能否接受估算值而不是精确计数?
| 端点类型 | 建议算法 | 理由 |
|---|---|---|
| 公开的开发者 API | 滑动窗口计数器或令牌桶 | 两者都能容忍合理的突发,且无需精确计数的开销 |
| 支付与认证 | 滑动窗口日志,或默认失败拒绝 | 需要精确计数,且拒绝比放行可疑流量更安全 |
| 受下游服务限制的流程 | 漏桶 | 输出速率永远不会超过后端的承受能力 |
| 高流量、低风险的内部流量 | 固定窗口 | 实现最简单,且边界突发是可以接受的 |
如果您无法说明 Redis 不可达时会发生什么,那么无论选择哪种算法,设计都尚未完成。
如何告知客户端其限额?
在响应头中发送当前的限额状态,并在每个 429 响应中发送 Retry-After。客户端不应需要猜测自己所处的状态。
IETF HTTP API 工作组正在将相关请求头标准化,对应的互联网草案为 HTTP 的 RateLimit 请求头字段。在当前修订版(2026 年 5 月的第 11 版)中,RateLimit-Policy 字段描述配额,RateLimit 字段报告剩余量:
RateLimit-Policy: "default";q=100;w=60RateLimit: "default";r=50;t=30其中 q 是配额,w 是窗口的秒数,r 是剩余配额,t 是窗口重置前的秒数。这取代了更早的草案版本,后者使用独立的 RateLimit-Limit、RateLimit-Remaining 和 RateLimit-Reset 字段。许多 API 仍在发送带厂商前缀的 X-RateLimit-* 请求头,它们早于该草案。由于草案尚未定稿,在确定格式之前,请先核对当前的修订版。
被拒绝的请求应使用状态码 429,RFC 6585 将其定义为“请求过多”。响应可以包含 Retry-After 请求头,其值为需要等待的秒数,如该 RFC 的示例所示:
HTTP/1.1 429 Too Many RequestsRetry-After: 3600在实践中请遵循以下规则:
- 在每个响应中发送限额请求头,而不仅仅是在拒绝时发送。
- 每当以 429 拒绝请求时,都发送
Retry-After。 - 将这些请求头视为提示。草案明确指出,客户端不得假设可用配额为正就保证后续请求会被处理。
- 在客户端使用带抖动的指数退避,而不是固定延迟,以免重试在同一时刻成批到达。
如何设定补充速率、容量与告警?
从实测流量出发,而不是凭猜测。从监控系统中拉取每个客户端的 p95 和 p99 每秒请求数,并把补充速率设定在持续 p99 略高的位置,使正常使用永远不会触发限流。桶的容量则应足以吸收约 5 到 10 秒的 p99 流量。这些只是起始值,并非标准。
举例来说,若某个客户端的 p99 为每秒 20 次请求,补充速率为每秒 24 个令牌,容量为 200 个令牌,则可允许一次 200 次请求的突发。突发之后,桶需要 200 / 24,约 8.3 秒,才能完全补满。
限流器上线后,请关注以下信号:
- 429 比率,以及其占全部请求的比例,而不仅仅是原始数量。
- 被限流流量与未被限流流量的延迟,分别跟踪,因为前者的上升往往先于后者。
- 与限流器相关的 Redis 命令失败或超时,因为无声的失败会让整个系统形同虚设。
限额变更应先向一小部分流量推出,待 429 比率和延迟看起来稳定之后,再逐步扩大范围。
**专业提示:**当您收紧限额时,请在上线之前向 API 使用者通知变更内容和新的响应头。没有任何背景的突发 429 所产生的支持工单,往往比它原本要阻止的滥用还要多。
这些模式在生产环境中的应用
大多数生产环境会把执行分为两层。
- **边缘层:**NGINX 漏桶配置,在滥用流量和明显的抓取行为到达应用服务器之前将其吸收。
- **应用层:**实现令牌桶或滑动窗口计数器的 Redis Lua 脚本,执行按键的限额,通常在只读端点上失败放行。
- **公开的开发者 API:**滑动窗口计数器或令牌桶,并根据客户端的套餐等级进行调整。
- **认证端点:**严格、低容量的限额,通常失败拒绝。
- **Webhook 处理器:**漏桶或由队列支撑的限流器,因为发送方的重试需要平滑处理,而不是直接拒绝。
公平性与滥用防护
当需求超过容量时,限流决定哪些请求得到处理,而这一决定会影响真实用户。限制过严,会在流量高峰期把正当客户挡在门外。限制过松,则会让少数滥用客户拖垮所有人的服务。
在 API 文档中公布您的限额,因为未经说明的节流会显得随意。对相似的客户端一视同仁地应用限额。在服务条款中说明什么算作滥用流量,例如撞库或抓取,并与付费客户的大流量正常使用加以区分。
对于多租户平台,应按租户隔离限额。这样,某个客户的流量高峰,无论是正当的还是恶意的,都无法耗尽同一基础设施上其他租户的配额。
来源
- 用 Redis 构建 5 种限流器:固定窗口、滑动窗口、令牌桶与漏桶
- HTTP 的 RateLimit 请求头字段(IETF 草案)
- Counting things: a lot of different things(Cloudflare)
- RFC 6585:其他 HTTP 状态码
常见问题
有哪些有效的限流策略?
将适合流量模式的算法与原子化执行结合起来。滑动窗口计数器适合通用 API,令牌桶适合有突发特征的客户端。原子化执行意味着并发请求无法绕过限额。像 Cloudflare 的做法那样,在边缘设置限额并叠加按键的应用层限额,即可形成第二层防护。
如何实现 API 限流?
把计数器或令牌状态保存在 Redis 等共享存储中,并把读取、补充和消耗三个步骤封装在同一个原子 Lua 脚本中。在每个响应中返回 RateLimit 请求头,并在拒绝时返回 Retry-After 请求头,使客户端知道该如何应对。
如何为 API 设计限流?
检查您的内存预算、突发容忍度,以及下游系统的脆弱程度。然后让算法与这些约束相匹配:公开 API 使用滑动窗口计数器或令牌桶,敏感端点使用滑动窗口日志或默认失败拒绝。根据实测的 p99 流量调整补充速率。
API 限流是什么意思?
API 限流限制客户端在给定时间段内可以发出的请求数量。它保护服务免于过载,并使各客户端之间的使用保持公平。服务器通常会在响应头中报告限额和剩余配额,IETF RateLimit 请求头草案正在对此进行标准化。
推荐阅读
准备好自己动手构建了吗? 获取你的 API key — 7 天试用,无需信用卡 — 或查看 区块链 API 获取完整的 endpoint 参考。