Limitación de tasa de API: estrategias para desarrolladores
Compare ventana fija, ventana deslizante, cubo de tokens y cubo con fugas; impleméntelos de forma atómica con Redis Lua y envíe cabeceras RateLimit.
Revisado por Maurice Sobiera
La limitación de tasa de API restringe cuántas solicitudes puede enviar un cliente en un periodo, para que nadie sature el servicio. Para la mayoría de las API públicas, el contador de ventana deslizante es la opción por defecto: su precisión es casi exacta y usa memoria constante por cliente. Use un cubo de tokens si quiere permitir ráfagas.
TL;DR:
- Un contador de ventana deslizante equilibra precisión y memoria, lo que lo hace adecuado para API públicas generales con mucho tráfico.
- Los scripts Lua de Redis hacen atómicos los pasos de lectura, recarga y consumo, de modo que las solicitudes concurrentes no compiten entre sí.
- Una tasa de recarga algo superior al p99 de tráfico normal y una capacidad de 5 a 10 segundos de ráfaga son valores iniciales razonables.
- Informe a los clientes de sus límites con cabeceras RateLimit y envíe Retry-After con cada respuesta 429.
- Aplique los límites en el borde y en la aplicación, y decida para cada endpoint qué pasa cuando Redis no está disponible.
Tabla de contenidos
- ¿Cómo se comparan los principales algoritmos de limitación de tasa?
- Notas de implementación para cada algoritmo
- ¿Cómo se construye un limitador que funcione entre instancias?
- ¿Qué algoritmo encaja con cada endpoint?
- ¿Cómo se informa a los clientes de sus límites?
- Cómo definir tasas de recarga, capacidad y alertas
- Dónde aparecen estos patrones en producción
- Equidad y prevención del abuso
- Fuentes
- Preguntas frecuentes
¿Cómo se comparan los principales algoritmos de limitación de tasa?
Cinco algoritmos cubren casi todos los casos de producción. Cada uno se sitúa en un punto distinto entre coste de memoria, tolerancia a ráfagas y precisión. El tutorial de limitación de tasa de Redis compara los mismos cinco, y la tabla siguiente sigue su estructura.
| Algoritmo | Estado por cliente | Precisión | Comportamiento ante ráfagas | Uso típico |
|---|---|---|---|---|
| Ventana fija | Un contador | Aproximada | Permite hasta el doble del límite en los bordes de la ventana | Límites sencillos de API, limitación de inicios de sesión |
| Registro de ventana deslizante | Conjunto ordenado de marcas de tiempo | Exacta | Sin ráfagas | APIs de alto valor, registros de auditoría |
| Contador de ventana deslizante | Dos contadores | Casi exacta | Límites suavizados | Límites generales de API |
| Cubo de tokens | Hash con número de tokens y tiempo de recarga | Exacta | Permite ráfagas controladas | Tráfico con ráfagas y un tope de tasa media |
| Cubo con fugas | Hash con uno o dos campos | Exacta | Sin ráfagas, drenaje constante | Control o modelado del tráfico delante de un backend frágil |
Elija según la restricción principal. La ventana fija es la más barata de ejecutar. El registro de ventana deslizante es exacto, pero su memoria crece con el volumen de solicitudes. El contador de ventana deslizante ofrece resultados casi exactos con memoria constante. El cubo de tokens sirve a las API para desarrolladores que necesitan margen para ráfagas, y el cubo con fugas, a las colas situadas delante de backends sensibles a la tasa.
Notas de implementación para cada algoritmo
Cada algoritmo necesita una forma de estado concreta y tiene su propio coste en tiempo de ejecución. Por eso, elegir uno equivale, en la práctica, a elegir una estructura de datos.
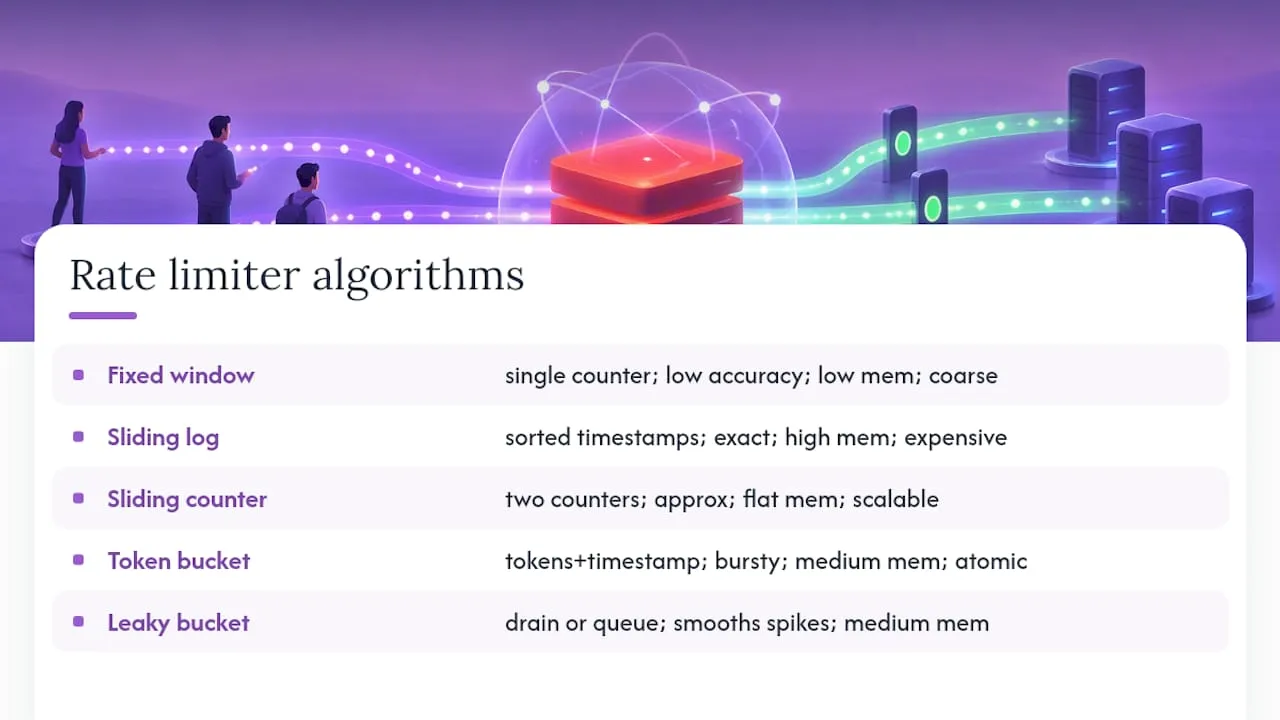
La ventana fija guarda un contador por cliente e intervalo de tiempo. Incrementa el contador con cada solicitud y lo reinicia cuando cambia el intervalo. Su punto débil está en el límite entre intervalos. Con un límite de 100 solicitudes por minuto, un cliente puede enviar 100 solicitudes a las 12:00:59 y otras 100 a las 12:01:00. Son 200 solicitudes en dos segundos, así que use la ventana fija solo para límites gruesos y de bajo riesgo.
El registro de ventana deslizante mantiene, por cliente, un conjunto ordenado de marcas de tiempo de sus solicitudes. En cada comprobación elimina las entradas más antiguas que la ventana. Es exacto porque cuenta solicitudes reales. Su memoria crece con el volumen de solicitudes, lo que lo encarece para clientes con mucho tráfico.
El contador de ventana deslizante guarda dos contadores: uno para la ventana actual y otro para la anterior. Pondera el recuento de la ventana anterior según la parte de esa ventana que aún se solapa con la ventana deslizante. Tome un límite de 100 por minuto, 80 solicitudes en el minuto anterior y 30 hasta ahora en el minuto actual, con un 25 por ciento de ese minuto transcurrido. La estimación es 80 × 0,75 + 30 = 90. Al cliente le quedan unas 10 solicitudes.
Cloudflare describe este enfoque para su propia limitación de tasa. Solo necesita dos cifras por contador. En un análisis de 400 millones de solicitudes procedentes de 270.000 fuentes distintas, según Cloudflare, el 0,003 por ciento de las solicitudes se permitió o se limitó de forma errónea.
El cubo de tokens guarda por cliente un número de tokens y una marca de tiempo de la última recarga. En cada solicitud calcula los tokens obtenidos desde la comprobación anterior, limita el total a la capacidad del cubo y descuenta un token si hay alguno disponible. La recarga y el consumo deben ocurrir de forma atómica. Si no, dos solicitudes concurrentes pueden leer el mismo número de tokens y ambas tener éxito cuando solo una debería tenerlo.
El cubo con fugas tiene dos variantes. La forma de control descarta las solicitudes que superan la tasa de drenaje. La forma de modelado las pone en cola para procesarlas más tarde. Úselo cuando el endpoint esté delante de una base de datos o de un servicio de terceros que no puede absorber picos.
Consejo profesional: Agrupe la recarga y el consumo en un único script Lua en lugar de hacer llamadas GET y SET por separado. Una secuencia de lectura y escritura en dos viajes de ida y vuelta es justo la condición de carrera que los scripts atómicos existen para evitar.
¿Cómo se construye un limitador que funcione entre instancias?
Mantenga los contadores en Redis y haga atómica cada actualización. Un limitador que funciona en un solo proceso pero falla bajo concurrencia es peor que ninguno, porque da una falsa sensación de protección.
- Guarde los contadores en Redis para que cada instancia de la aplicación lea y escriba el mismo estado.
- Use scripts Lua de Redis para combinar los pasos de lectura, recarga y consumo en una sola operación atómica. El tutorial de Redis explica por qué: con comandos separados, las solicitudes concurrentes pueden leer el mismo estado, decidir ambas que están permitidas y escribir ambas el resultado.
- En servicios de alto volumen, agregue los recuentos localmente por instancia o por punto de presencia antes de sincronizarlos con un almacén central. Así se evita una llamada a Redis en cada solicitud.
- Añada en la puerta de enlace un cubo con fugas, por ejemplo en NGINX, como muro exterior frente al tráfico abusivo. Mantenga los límites más finos por clave en la aplicación.
- Decida para cada endpoint entre fail-open y fail-closed antes de que un incidente le obligue a hacerlo.
Aplique fail-open en los endpoints públicos de lectura intensiva, para que una caída de Redis no tumbe toda la API. Aplique fail-closed en los endpoints de autenticación y de pagos, donde el tráfico sin límite supone el mayor riesgo.
Consejo profesional: Registre cada evento fail-open por separado del tráfico normal. Una caída de Redis que desactiva en silencio sus límites suele aparecer solo en la revisión posterior a un incidente.
¿Qué algoritmo encaja con cada endpoint?
Antes de escribir código, compruebe cuatro cosas. ¿Cuánta memoria puede gastar por cliente? ¿Son legítimas las ráfagas o son una amenaza? ¿Qué tan frágil es el sistema downstream? ¿Son aceptables las estimaciones en lugar de recuentos exactos?
| Tipo de endpoint | Algoritmo sugerido | Motivo |
|---|---|---|
| API públicas para desarrolladores | Contador de ventana deslizante o cubo de tokens | Ambos toleran ráfagas razonables sin la carga de un recuento exacto |
| Pagos y autenticación | Registro de ventana deslizante, o un valor predeterminado fail-closed | Recuentos exactos, y rechazar es más seguro que dejar pasar tráfico sospechoso |
| Flujos limitados por un servicio downstream | Cubo con fugas | La tasa de salida nunca supera lo que el backend puede soportar |
| Tráfico interno de alto volumen y bajo riesgo | Ventana fija | La implementación más sencilla, y las ráfagas en los bordes son aceptables |
Si no puede decir qué ocurre cuando Redis no es accesible, el diseño no está terminado, sea cual sea el algoritmo elegido.
¿Cómo se informa a los clientes de sus límites?
Envíe el estado actual del límite en las cabeceras de respuesta y envíe Retry-After con cada 429. Los clientes no deberían tener que adivinar en qué situación están.
El grupo de trabajo HTTP API del IETF está normalizando las cabeceras en el borrador de Internet RateLimit header fields for HTTP. En la revisión actual (draft 11, mayo de 2026), el campo RateLimit-Policy describe la cuota y el campo RateLimit indica lo que queda:
RateLimit-Policy: "default";q=100;w=60RateLimit: "default";r=50;t=30Aquí q es la cuota, w es la ventana en segundos, r es la cuota restante y t son los segundos hasta que se reinicia la ventana. Esto sustituye a las revisiones anteriores del borrador, que usaban los campos separados RateLimit-Limit, RateLimit-Remaining y RateLimit-Reset. Muchas API todavía envían las cabeceras X-RateLimit-* con prefijo de proveedor, que son anteriores al borrador. Como el borrador no es definitivo, compruebe la revisión vigente antes de fijar un formato.
Una solicitud rechazada debe usar el código de estado 429, que RFC 6585 define como Too Many Requests. La respuesta puede incluir una cabecera Retry-After con el número de segundos de espera, como en el ejemplo de la RFC:
HTTP/1.1 429 Too Many RequestsRetry-After: 3600En la práctica, siga estas reglas:
- Envíe las cabeceras de límite en cada respuesta, no solo en los rechazos.
- Envíe
Retry-Aftersiempre que rechace una solicitud con un 429. - Trate las cabeceras como indicaciones. El borrador establece que los clientes no deben suponer que una cuota disponible positiva garantiza que se atenderán las solicitudes siguientes.
- En el cliente, use retroceso exponencial con jitter en lugar de una espera fija, para que los reintentos no lleguen en oleadas sincronizadas.
Cómo definir tasas de recarga, capacidad y alertas
Parta de tráfico medido, no de una suposición. Obtenga de sus métricas los p95 y p99 de solicitudes por segundo por cliente, y fije la tasa de recarga algo por encima del p99 sostenido, para que el uso normal nunca active el limitador. Dimensione la capacidad del cubo para absorber unos 5 a 10 segundos de tráfico p99. Son valores iniciales, no un estándar.
Por ejemplo, si un cliente tiene un p99 de 20 solicitudes por segundo, una tasa de recarga de 24 por segundo y una capacidad de 200 tokens permiten una ráfaga de 200 solicitudes. Tras esa ráfaga, el cubo necesita 200 / 24, unos 8,3 segundos, para recargarse por completo.
Vigile estas señales una vez que el limitador esté en producción:
- La tasa de 429 y la proporción de solicitudes limitadas sobre el total, no solo los recuentos brutos.
- La latencia del tráfico limitado y la del no limitado, medidas por separado, ya que un aumento de la primera suele anticiparse a un aumento de la segunda.
- Los fallos o timeouts de comandos de Redis vinculados al limitador, porque un fallo silencioso anula todo el sistema.
Despliegue los cambios de límite primero en una pequeña parte del tráfico y amplíelos cuando la tasa de 429 y la latencia parezcan estables.
Consejo profesional: Cuando endurezca un límite, anuncie el cambio y las nuevas cabeceras a los consumidores de la API antes de publicarlo. Un 429 sorpresivo sin contexto genera más tickets de soporte que el abuso que pretendía frenar.
Dónde aparecen estos patrones en producción
La mayoría de las pilas de producción reparten la aplicación de límites entre dos capas.
- Borde: una configuración de cubo con fugas en NGINX absorbe el tráfico abusivo y el scraping evidente antes de que llegue a los servidores de aplicación.
- Aplicación: un script Lua de Redis que implementa un cubo de tokens o un contador de ventana deslizante aplica límites por clave, normalmente con fail-open en los endpoints de solo lectura.
- API públicas para desarrolladores: contador de ventana deslizante o cubo de tokens, ajustado al nivel de plan del cliente.
- Endpoints de autenticación: límites estrictos y de baja capacidad, a menudo fail-closed.
- Procesadores de webhooks: cubo con fugas o un limitador respaldado por una cola, porque los reintentos del servicio emisor necesitan suavizarse en lugar de rechazarse de forma directa.
Equidad y prevención del abuso
La limitación de tasa decide qué solicitudes se atienden cuando la demanda supera la capacidad, y esa decisión afecta a usuarios reales. Un límite demasiado estricto bloquea a clientes legítimos durante un pico de tráfico. Un límite demasiado laxo permite que unos pocos clientes abusivos degraden el servicio para todos.
Publique sus límites en la documentación de la API, porque una limitación no documentada parece arbitraria. Aplique los límites de forma coherente a clientes similares. Defina en sus condiciones qué se considera tráfico abusivo, como el credential stuffing o el scraping, frente al uso intensivo por parte de un cliente que paga.
En plataformas multiinquilino, aísle los límites por inquilino. Así, el pico de un cliente, sea legítimo o malicioso, no puede agotar la cuota de otro inquilino de la misma infraestructura.
Fuentes
- Build 5 Rate Limiters with Redis: Fixed Window, Sliding Window, Token Bucket, and Leaky Bucket
- RateLimit header fields for HTTP (borrador del IETF)
- Counting things: a lot of different things (Cloudflare)
- RFC 6585: Additional HTTP Status Codes
Preguntas frecuentes
¿Cuáles son algunas estrategias eficaces para la limitación de tasa?
Combine un algoritmo que encaje con el patrón de tráfico con una aplicación atómica. Un contador de ventana deslizante sirve para API generales, y un cubo de tokens, para clientes con ráfagas. La aplicación atómica significa que las solicitudes concurrentes no pueden saltarse el límite. Los límites en el borde más los límites por clave en la aplicación añaden una segunda capa, como en el enfoque de Cloudflare.
¿Cómo se implementa la limitación de tasa de API?
Guarde los contadores o el estado de los tokens en un almacén compartido como Redis, y encapsule los pasos de lectura, recarga y consumo en un único script Lua atómico. Devuelva cabeceras RateLimit en cada respuesta y una cabecera Retry-After en los rechazos, para que los clientes sepan cómo actuar.
¿Cómo diseñaría la limitación de tasa para una API?
Compruebe su presupuesto de memoria, su tolerancia a ráfagas y la fragilidad de los sistemas downstream. Después, asigne un algoritmo a esos límites: contador de ventana deslizante o cubo de tokens para API públicas, y registro de ventana deslizante o un valor predeterminado fail-closed para endpoints sensibles. Ajuste la tasa de recarga según el tráfico p99 medido.
¿Qué significa limitación de tasa de API?
La limitación de tasa de API restringe cuántas solicitudes puede hacer un cliente en un periodo dado. Protege el servicio de la sobrecarga y mantiene un uso equitativo entre clientes. Los servidores suelen indicar el límite y la cuota restante en las cabeceras de respuesta, algo que el borrador del IETF sobre cabeceras RateLimit está normalizando.
Recomendado
Cómo escribimos estos artículos
¿Listo para construirlo tú mismo? Obtenga su clave de API — prueba de 7 días, sin tarjeta — o consulte API Blockchain para la referencia completa de los endpoints.